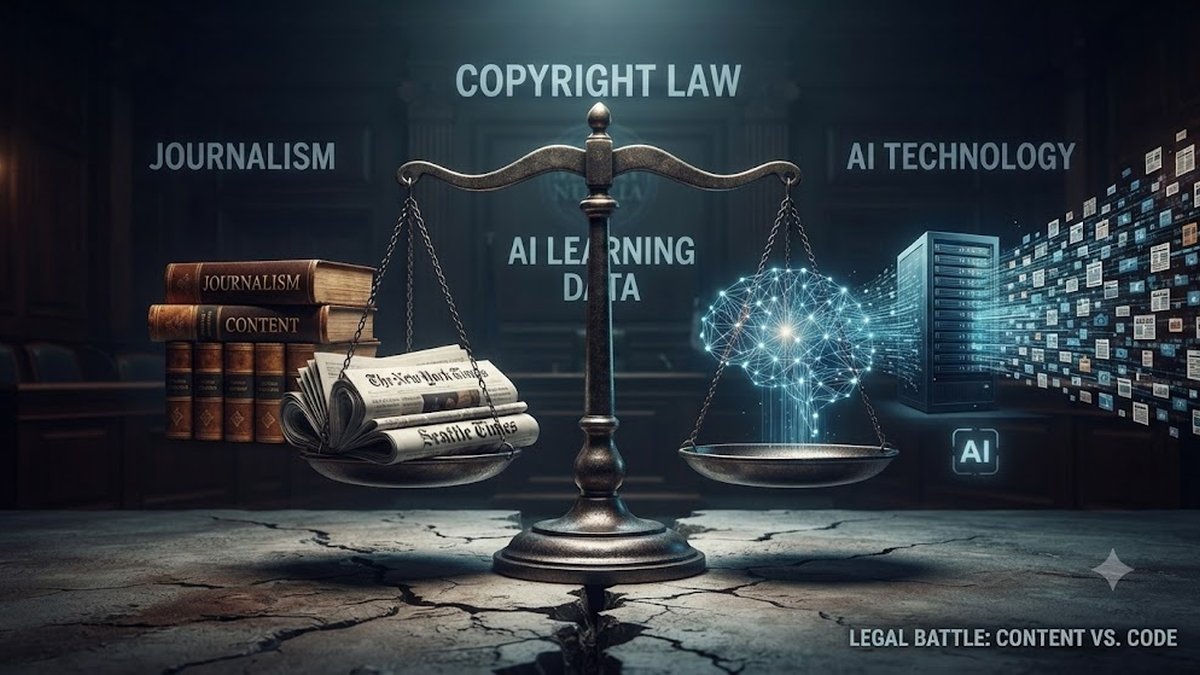
인공지능이 신문과 잡지 등 언론사의 콘텐츠를 학습에 사용하는 것이 저작권법상 허용되는지를 둘러싼 미국 법정 공방이 다시 주목받고 있다.
뉴욕 연방법원에서 진행 중인 뉴욕타임스와 오픈AI·마이크로소프트 간 저작권 소송과 관련해 9월 17일 법원에 제출된 자료 일부가 공개되면서 논쟁이 다시 커졌다.
언론사 측은 공개된 법정 자료에서 오픈AI와 마이크로소프트 관계자들이 자사 AI 제품이 기존 언론 콘텐츠를 대체할 가능성을 인정한 취지의 발언이 있었다고 주장했다. 반면 오픈AI와 마이크로소프트는 수백만 건의 기사 등을 AI 학습에 이용한 행위가 새로운 결과물을 만들어내는 ‘공정 이용(fair use)’에 해당한다는 주장을 이어가고 있다.
이번 사건의 핵심은 AI가 인터넷에 존재하는 수많은 저작물을 학습하는 과정에서 원저작자의 허락이나 보상이 반드시 필요한지 여부다. AI 기업들은 대규모 데이터를 학습해 새로운 결과물을 만들어내는 기술적 과정이라고 주장하지만, 일부 언론사와 저작권자들은 자신들의 콘텐츠가 허락 없이 상업적인 AI 서비스 개발에 이용되고 있다고 문제를 제기하고 있다.
특히 생성형 AI가 사용자의 질문에 기존 뉴스의 내용을 요약하거나 핵심 정보를 제공하면서 실제 언론사의 웹사이트를 방문하지 않아도 되는 상황이 늘어날 수 있다는 점이 쟁점이다. 언론사 입장에서는 콘텐츠 제작 비용을 들여 만든 기사가 AI의 답변을 통해 소비될 경우 광고와 구독 등 기존 수익 구조가 영향을 받을 수 있다는 우려가 있다.
비슷한 소송도 이어지고 있다. 시애틀타임스와 뉴스데이는 이달 초 오픈AI와 마이크로소프트를 상대로 별도의 저작권 소송을 제기하면서 AI 학습에 사용된 콘텐츠 문제를 법정으로 가져갔다.
반대로 AI 기업들은 저작권이 있는 자료를 학습에 사용했다고 해서 그 자체가 곧 저작권 침해를 의미하는 것은 아니며, AI가 생성하는 결과물이 원저작물을 그대로 복제하는 것과는 구분해야 한다는 입장이다.
법원의 최종 판단은 AI 산업뿐 아니라 언론사와 출판사, 음악·영상업계 등 콘텐츠 산업 전반에 영향을 미칠 수 있다. AI 학습 데이터에 대한 새로운 기준이 만들어질 경우 향후 콘텐츠 이용계약과 라이선스 시장의 구조에도 변화가 예상된다.